PDF से टेक्स्ट
PDF के टेक्स्ट से बार-बार आने वाले शीर्षलेख और पादलेख कैसे हटाएँ
पहले टेक्स्ट निकालें, फिर बार-बार आने वाले पृष्ठ लेबल जाँचकर हटाएँ। ध्यान रखें कि दस्तावेज़ के मुख्य भाग में मिलते-जुलते शब्द न हट जाएँ।
इस पृष्ठ पर
दृश्य उदाहरण देखें
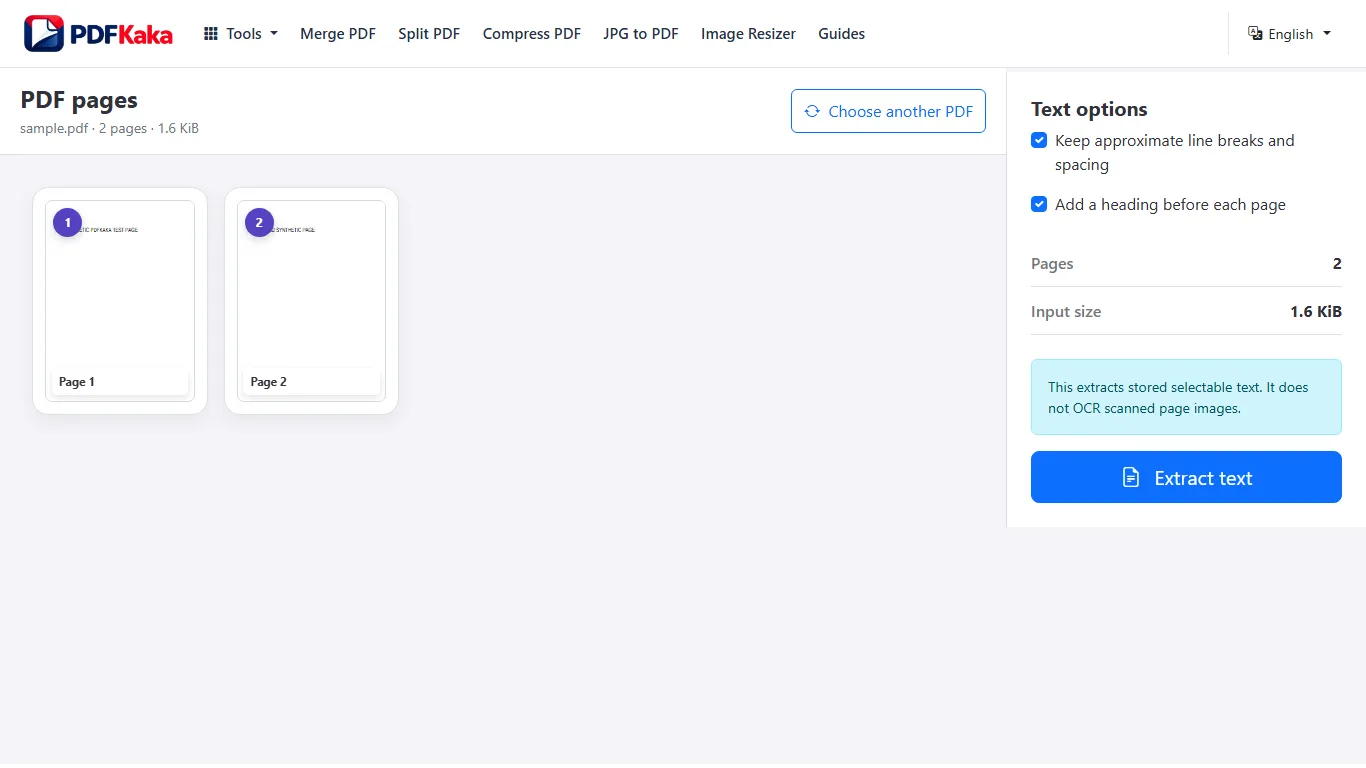
पीडीएफ पाठ निकालें
- टेक्स्ट के लिए पीडीएफ खोलें और उपयोग योग्य चयन योग्य टेक्स्ट वाला एक पीडीएफ चुनें।
- चुनें कि अनुमानित पंक्ति विराम और रिक्ति रखनी है या नहीं और पृष्ठ शीर्षक जोड़ना है या नहीं।
- टेक्स्ट निकालें और पूर्वावलोकन की समीक्षा करें, जिसमें कॉलम या तालिकाओं वाले पृष्ठ भी शामिल हैं।
- UTF-8 TXT फ़ाइल को नाम दें और डाउनलोड करें।
- सहेजे गए पाठ की तुलना पहले, मध्य और अंतिम स्रोत पृष्ठों से करें; यदि आवश्यक शब्द केवल छवियों में मौजूद हैं तो पहले OCR चलाएँ।
पाठ निष्कर्षण OCR का स्थान नहीं लेता
केवल संग्रहित चयन योग्य पाठ को निकालें; कोई ओसीआर नहीं और कोई पृष्ठ छवियाँ नहीं।
हर पृष्ठ पर दोहराया गया रिपोर्ट का शीर्षक
Monthly Operations Report जैसी पंक्ति पृष्ठ के शीर्षलेख में बार-बार आ सकती है और किसी सार्थक वाक्य में भी एक बार मौजूद हो सकती है। केवल पुष्टि किए गए शीर्षलेख वाले स्थान हटाएँ। एक जैसे शब्द वाली हर पंक्ति हटाने के बजाय पृष्ठ संख्याओं और गोपनीयता लेबलों की अलग-अलग जाँच करें।
इसका पुन: उपयोग करने से पहले इस परिणाम की जाँच करें
- मूल शीर्षलेखों और उपकरण के वैकल्पिक अतिरिक्त पृष्ठ शीर्षकों में अंतर पहचानें।
- दोहराई गई हर पंक्ति हटाने से पहले उसके आसपास का मुख्य टेक्स्ट देखें।
- सफाई के बाद पहले और अंतिम पृष्ठ की तुलना करें।
अक्सर पूछे जाने वाले सवाल
क्या PDF to Text स्कैन किए गए पृष्ठों पर OCR करता है?
नहीं। PDF to Text केवल वह टेक्स्ट निकालता है जो PDF में पहले से मौजूद है। केवल चित्रों वाले स्कैन के लिए पहले OCR PDF का उपयोग करें।
PDF to Text की वर्तमान इनपुट सीमा क्या है?
अधिकतम 50 MiB और 500 पृष्ठों वाली एक PDF, जिससे अधिकतम 1,000,000 अक्षर निकाले जा सकते हैं। टेक्स्ट का आउटपुट दिखाई गई आउटपुट बाइट सीमा में भी होना चाहिए।
PDF to Text किस प्रकार का आउटपुट बनाता है?
यह कन्वर्टर PDF में संग्रहीत चयन योग्य टेक्स्ट से UTF-8 TXT बनाता है। इसमें अनुमानित रिक्ति और अतिरिक्त पृष्ठ शीर्षक के वैकल्पिक विकल्प हैं। यह OCR नहीं करता, पृष्ठों की छवियाँ शामिल नहीं करता और बार-बार आने वाले शीर्षलेख अपने आप नहीं हटाता।
क्या अतिरिक्त पृष्ठ शीर्षक बंद करने से PDF के मूल शीर्षलेख हट जाते हैं?
नहीं। इससे केवल उपकरण के अतिरिक्त पृष्ठ चिह्न बंद होते हैं। मूल शीर्षलेख या पादलेख में संग्रहीत टेक्स्ट अब भी निकाला जा सकता है और उसकी अलग से जाँच करनी होगी।