PDF в текст
Как удалить повторяющиеся колонтитулы из текста PDF
Сначала извлеките текст, затем проверьте и удалите повторяющиеся метки страниц, не удаляя похожие слова из основного текста документа.
На этой странице
Посмотреть пример
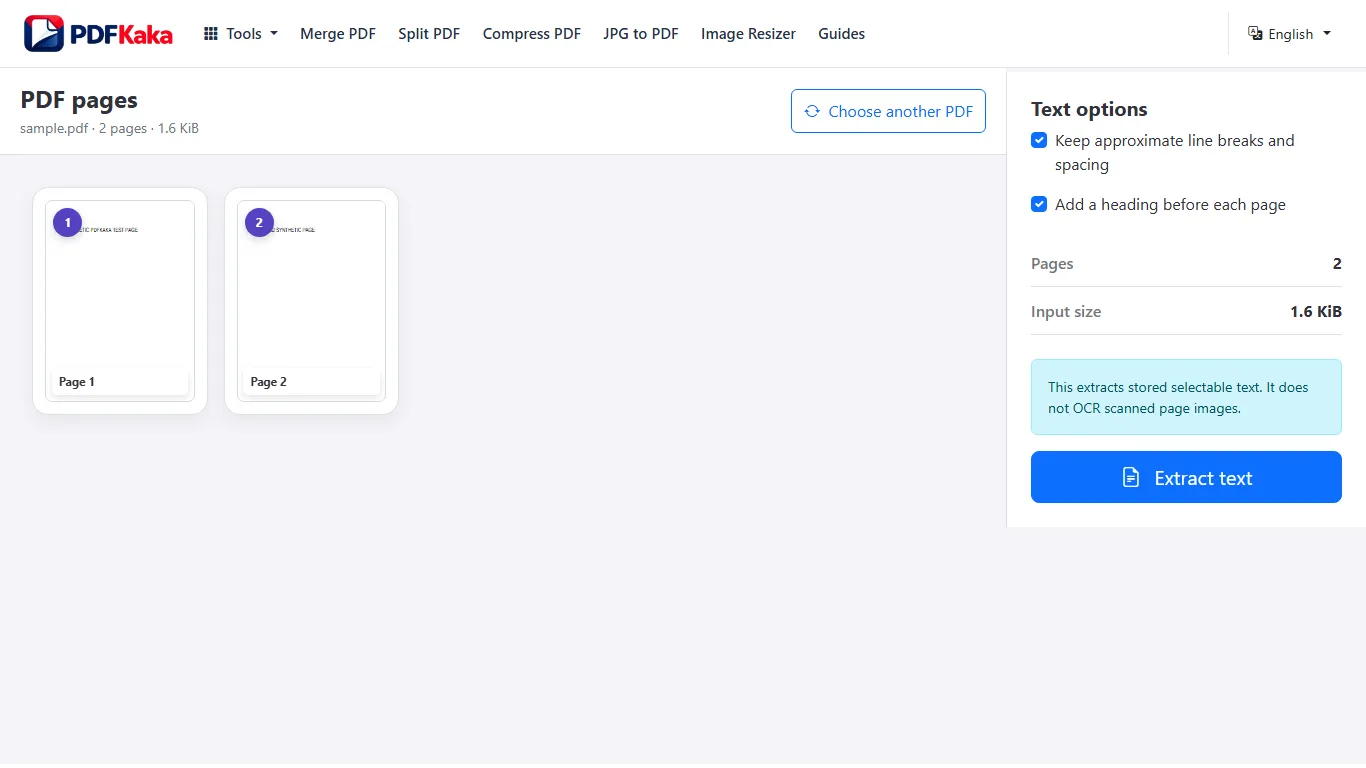
Извлечение текста PDF
- Откройте «PDF в текст» и выберите PDF с пригодным выделяемым текстом.
- Выберите, сохранять ли приблизительные переносы строк и пробелы и добавлять ли заголовки страниц.
- Извлеките текст и проверьте предпросмотр, включая страницы с колонками и таблицами.
- Задайте имя и скачайте файл UTF-8 TXT.
- Сравните сохранённый текст с первой, средней и последней исходными страницами; сначала выполните OCR, если нужные слова есть только на изображениях.
Извлечение текста не заменяет OCR
Извлекается только сохранённый выделяемый текст; без OCR и изображений страниц.
Название отчёта на каждой странице
Строка вроде «Ежемесячный операционный отчёт» может повторяться в колонтитуле и один раз встречаться в содержательном предложении. Удаляйте только проверенные вхождения в колонтитулах. Проверяйте номера страниц и метки конфиденциальности отдельно, а не удаляйте каждую строку с тем же словом.
Проверьте результат перед дальнейшим использованием
- Отличайте исходные колонтитулы от необязательных заголовков Page, добавляемых инструментом.
- Проверяйте окружающий основной текст перед удалением каждой повторяющейся строки.
- После очистки сравните первую и последнюю страницы.
Частые вопросы
Выполняет ли «PDF в текст» OCR сканированных страниц?
Нет. «PDF в текст» извлекает текст, уже существующий в PDF. Для сканов только с изображениями сначала используйте «OCR PDF».
Каков текущий лимит входных данных в «PDF в текст»?
Один PDF до 50 MiB и 500 страниц, до 1 000 000 извлечённых символов. Текстовый результат также должен укладываться в указанный лимит выходных байтов.
Что создаёт «PDF в текст»?
Конвертер извлекает сохранённый выделяемый текст в UTF-8 TXT с необязательными приблизительными пробелами и дополнительными заголовками страниц. Он не выполняет OCR, не включает изображения страниц и не удаляет повторяющиеся колонтитулы автоматически.
Удаляет ли отключение добавленных заголовков страниц исходные колонтитулы PDF?
Нет. Оно лишь отключает дополнительные метки инструмента. Текст исходных верхних и нижних колонтитулов по-прежнему может извлекаться и требует отдельной проверки.