Перейти к основному содержанию

Распознавание текста PDF онлайн

Выполняйте оптическое распознавание символов на поддерживаемых сканах или изображениях страниц PDF, чтобы распознанный текст стал доступен для поиска. Результат зависит от поддержки языка, качества скана, разрешения, поворота и вёрстки документа.

или перетащите сюда файл

До 50 MiB на PDF

Распознавание английского текста · до 25 страниц

Файлы остаются в вашем браузере Без загрузки файлов Учётная запись не требуется

Как сделать отсканированный PDF доступным для поиска

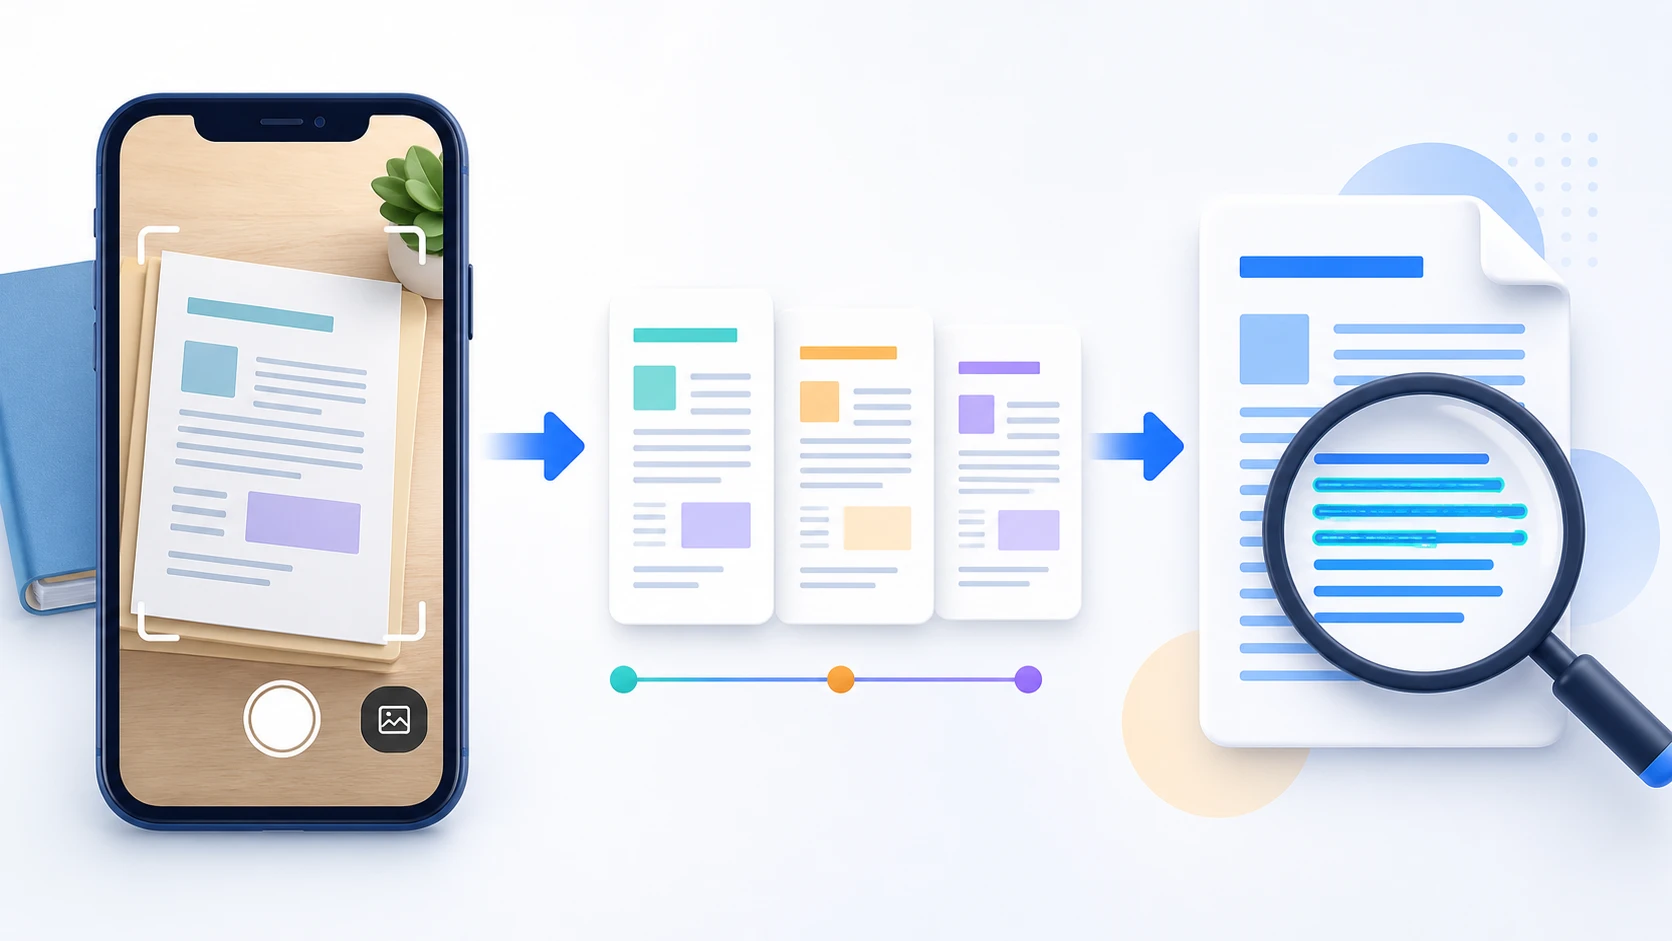
  1. Выберите поддерживаемый сканированный PDF или PDF на основе изображений.
  2. Запустите распознавание текста.
  3. Скачайте PDF после распознавания текста.
  4. Откройте скачанный PDF и проверьте важные имена, числа или термины.
Вопросы об обработке в браузере

Что такое распознавание текста?

Оптическое распознавание символов анализирует изображения страниц и пытается определить символы, чтобы распознанный текст можно было искать или извлекать.

Какие языки поддерживает распознавание PDFKaka?

Распознавание PDFKaka сейчас поддерживает печатный английский текст.

Может ли OCR читать рукописный текст?

Текущее распознавание предназначено для печатного английского текста, а не рукописного.

Будет ли распознавание полностью точным?

Нет. Точность зависит от качества скана, разрешения, поворота, языка, шрифтов, вёрстки и самого содержимого. Проверяйте важный текст вручную.

Меняет ли распознавание видимый скан?

Распознавание пересоздаёт каждую страницу как изображение JPEG и добавляет доступный для поиска текстовый слой. Исходные байты изображения страницы не сохраняются неизменными.

Мои файлы загружаются на PDFKaka?

Нет. Содержимое выбранного PDF обрабатывается локально в этом браузере. Ресурсы распознавания загружаются с PDFKaka только при его запуске.

Нужно выполнить другую задачу с документом? Все инструменты.

Об этом инструменте

Превращайте сканы, содержащие только изображения, в PDF с поиском там, где распознавание успешно

Распознавание PDF полезно, если скан содержит печатный текст, но не имеет выделяемого текстового слоя. Идеальная точность и восстановление любой вёрстки в виде редактируемого документа не гарантируются.

Подходит для

  • Ищите печатный текст внутри поддерживаемых сканов документов.
  • Копируйте распознанный текст там, где результат OCR достаточно точен.
  • Подготовьте отсканированный PDF для задач, которым полезен доступный для поиска текст.

Полезно знать

  • Движок распознавания сейчас поддерживает только английский язык.
  • Текущий процесс предназначен для печатного текста, а не рукописного.
  • Точность распознавания сильно зависит от качества скана, ориентации, контрастности и оформления текста.
Практические рекомендации

Используйте распознавание, чтобы сделать текст сканов PDF доступным для поиска

Распознавание PDF предназначено для страниц, которые выглядят как текст, но работают как изображения. Оно локально распознаёт печатные английские символы на сканах и добавляет доступный для поиска текстовый слой. Результат может позволить поиск и копирование, но распознавание неточно, поэтому важные значения всегда нужно проверять.

Преобразование сканированного PDF в PDF с поиском

Каждая страница отрисовывается для распознавания, а распознанный английский текст добавляется в новый PDF. Это может упростить поиск и повторное использование сканов, содержащих только изображения.

Подготовьте распознанный текст для Word или TXT

После OCR используйте «PDF в текст» или «PDF в Word», если главная цель — повторное использование текста. Сложный макет, колонки и таблицы всё ещё могут требовать ручного исправления.

Повысьте точность распознавания перед обработкой

Ровные страницы, чёткие печатные символы, хороший контраст и достаточное разрешение помогают распознаванию. Рукописный текст, тени, изгибы страниц и размытые фотографии снижают точность.

Вопросы пользователей об этой задаче

Можно ли бесплатно распознать PDF онлайн?

Да. Текущий инструмент локально распознаёт поддерживаемый печатный английский текст без обязательной учётной записи.

Преобразует ли распознавание PDF файл сразу в Word?

Распознавание создаёт PDF с доступным для поиска текстом. Если нужен также редактируемый DOCX, откройте этот результат в преобразовании PDF в Word.

Может ли OCR читать рукописный текст или любой язык?

Нет. Текущий процесс предназначен для печатного английского текста. Рукописный текст и другие языки не являются надёжно поддерживаемыми исходными данными.