Taranmış PDF Nasıl Aranabilir Yapılır?
- Desteklenen taranmış veya görüntü tabanlı PDF seçin.
- OCR işlemini başlatın.
- OCR ile işlenmiş PDF’yi indirin.
- İndirilen PDF’yi açıp önemli adları, sayıları veya terimleri deneyin.
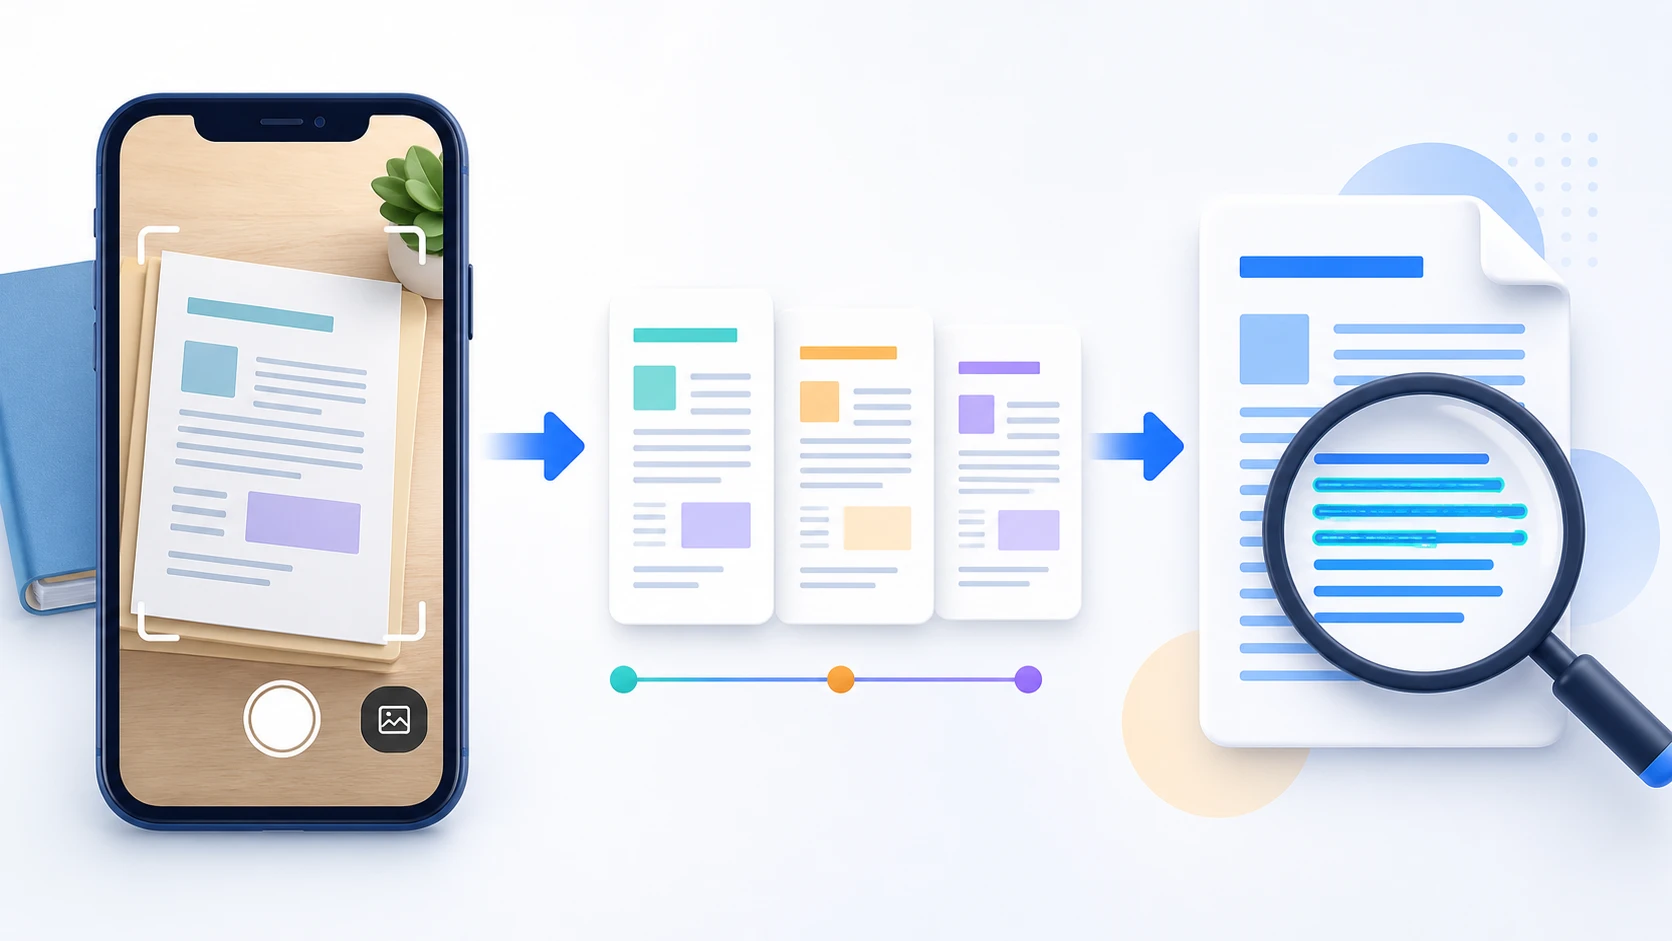
Tanınan metni aranabilir yapmak için desteklenen taranmış veya görüntü tabanlı PDF sayfalarında optik karakter tanıma çalıştırın. OCR sonuçları; dil desteğine, tarama kalitesine, çözünürlüğe, döndürmeye ve belge düzenine bağlıdır.
veya dosyayı buraya bırakın
PDF başına en fazla 50 MiB
İngilizce OCR · en fazla 25 sayfa
Optik karakter tanıma sayfa görüntülerini analiz edip karakterleri belirlemeye çalışır; böylece tanınan metin aranabilir veya çıkarılabilir olur.
PDFKaka OCR şu anda İngilizce basılı metni destekler.
Mevcut OCR iş akışı, el yazısı değil İngilizce basılı metin içindir.
Hayır. Doğruluk tarama kalitesine, çözünürlüğe, dönüşe, dile, yazı tiplerine, düzene ve içeriğin kendisine bağlıdır. Önemli metni elle inceleyin.
OCR her sayfayı JPEG görüntüsü olarak yeniden oluşturup aranabilir metin katmanı ekler. Özgün sayfa görüntüsü baytları değiştirilmeden korunmaz.
Hayır. Seçilen PDF içeriği bu tarayıcıda yerel işlenir. OCR dosyaları yalnızca tanıma başladığında PDFKaka’dan yüklenir.
Başka bir belge işlemi mi gerekiyor? Tüm araçlar.
OCR PDF, tarama basılı metin içerdiği ancak seçilebilir metin katmanı olmadığı zaman yararlıdır. Kusursuz tanıma veya her düzenin düzenlenebilir belge içeriği olarak yeniden kurulmasını garanti etmez.
OCR PDF metin gibi görünen ancak görüntü gibi davranan sayfalar içindir. Taranmış sayfalardaki basılı İngilizce karakterleri tanır ve yerel olarak aranabilir metin katmanı ekler. Sonuç aramayı ve kopyalamayı destekleyebilir ancak OCR mümkün olduğunca yapılır ve önemli değerler her zaman kontrol edilmelidir.
Her sayfa tanıma için işlenir ve algılanan İngilizce metin yeni PDF’ye eklenir. Bu, yalnızca görüntü içeren taramalarda aramayı ve yeniden kullanımı kolaylaştırabilir.
Asıl hedef yeniden kullanılabilir metinse OCR’den sonra PDF’den Metne veya PDF’den Word’e kullanın. Karmaşık düzenler, sütunlar ve tablolar yine elle düzeltme gerektirebilir.
Düz sayfalar, net basılı karakterler, iyi karşıtlık ve yeterli çözünürlük tanımaya yardımcı olur. El yazısı, gölgeler, eğri sayfalar ve bulanık fotoğraflar doğruluğu düşürür.
Evet. Araç, desteklenen basılı İngilizce metni hesap gerektirmeden yerel olarak tanır.
OCR aranabilir PDF oluşturur. Düzenlenebilir DOCX dosyası da gerekiyorsa bu sonucu PDF’den Word’e aracında açın.
Hayır. Mevcut iş akışı basılı İngilizce metin için tasarlanmıştır. El yazısı ve diğer diller güvenilir desteklenen girdiler değildir.
İhtiyacınız olan sonuçtan başlayın ve doğru araçlarla açık bir iş akışını izleyin.