Cómo hacer buscable un PDF escaneado
- Elige un PDF escaneado o basado en imágenes compatible.
- Inicia el procesamiento OCR.
- Descarga el PDF procesado con OCR.
- Abre el PDF descargado y prueba nombres, números o términos importantes.
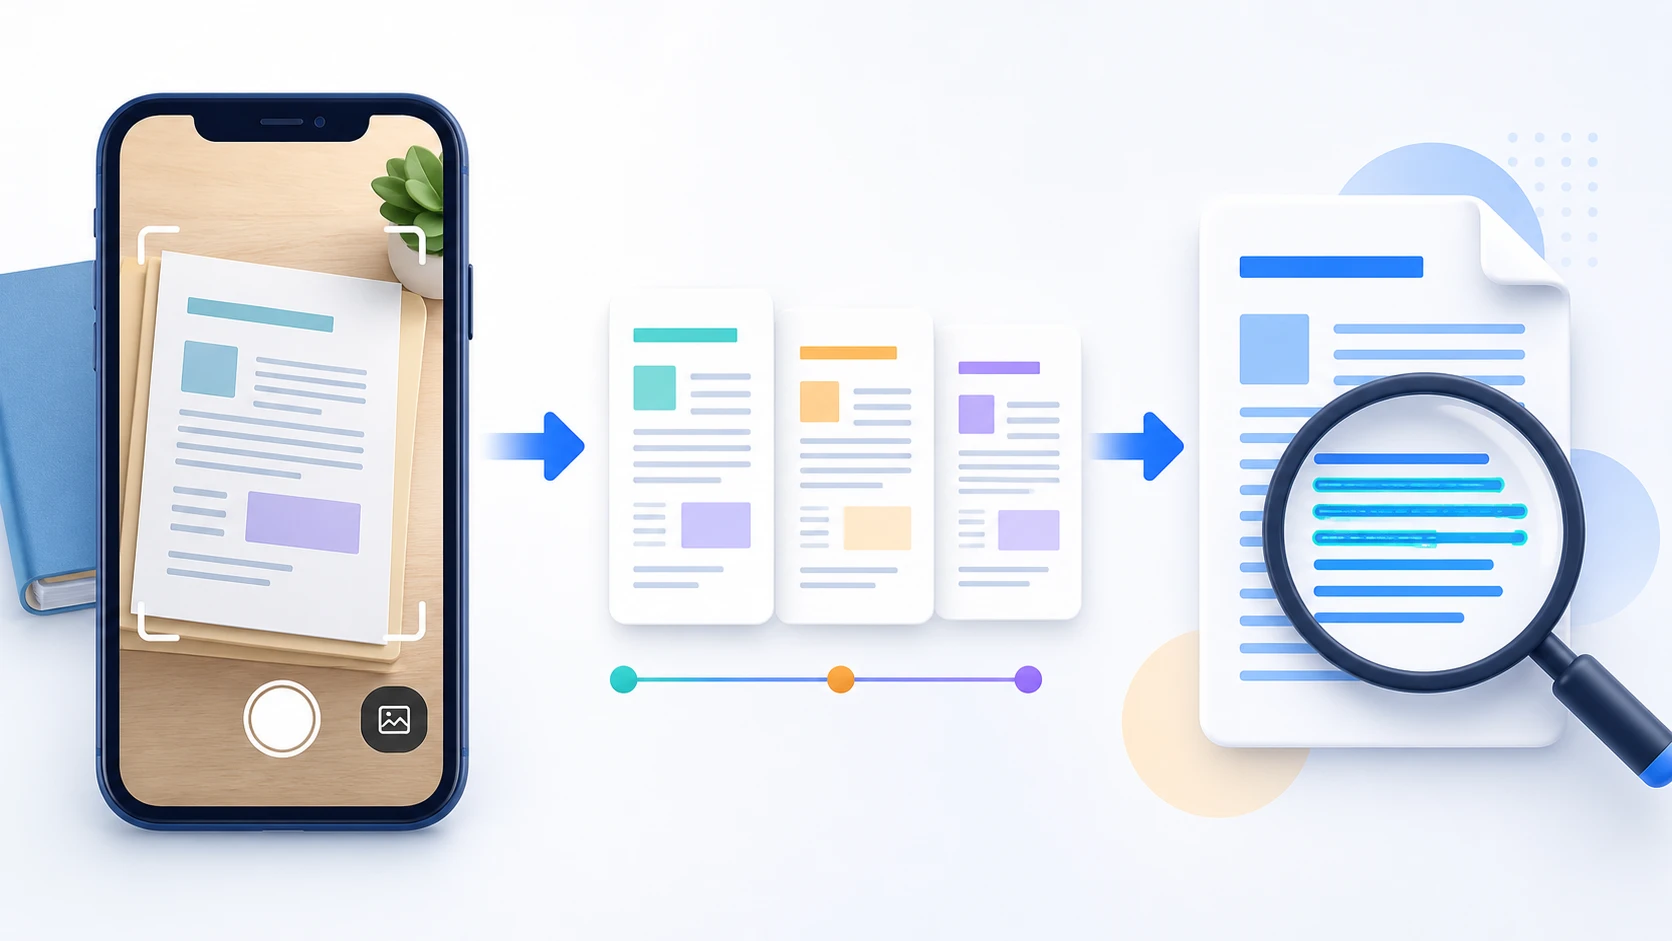
Ejecuta reconocimiento óptico en páginas escaneadas o de imagen compatibles para hacer buscable lo reconocido. Depende de idiomas, calidad, resolución, giro y diseño.
o suelta el archivo aquí
Hasta 50 MiB por PDF
OCR en inglés · hasta 25 páginas
El reconocimiento óptico analiza imágenes e intenta identificar caracteres para que el texto reconocido sea buscable o extraíble.
El OCR actual de PDFKaka admite inglés impreso.
El OCR actual está pensado para inglés impreso, no manuscritos.
No. La precisión depende de calidad, resolución, giro, idioma, fuentes, diseño y contenido. Revisa manualmente el texto importante.
OCR reconstruye cada página como JPEG y añade una capa buscable. No conserva intactos los bytes originales de imagen.
No. Los PDF se procesan localmente; los recursos OCR se cargan desde PDFKaka solo al iniciar reconocimiento.
¿Necesitas otra tarea con documentos? Todas las herramientas.
OCR PDF sirve si un escaneo contiene texto impreso sin capa seleccionable. No garantiza reconocimiento perfecto ni recrea todo diseño como contenido editable.
OCR PDF sirve para páginas que parecen texto pero funcionan como imágenes. Reconoce inglés impreso en escaneos y añade localmente una capa buscable. Permite buscar y copiar, pero el reconocimiento es aproximado y siempre debes comprobar los valores importantes.
Cada página se renderiza para reconocerla y el texto inglés detectado se añade a un PDF nuevo. Esto puede facilitar buscar y reutilizar escaneos de imagen.
Después del OCR, usa PDF a Texto o PDF a Word si buscas texto reutilizable. Los diseños complejos, columnas y tablas aún pueden necesitar corrección manual.
Páginas rectas, letras impresas claras, buen contraste y resolución adecuada ayudan. Manuscritos, sombras, páginas curvas y desenfoque reducen la precisión.
Sí. Reconoce inglés impreso compatible localmente sin cuenta.
OCR crea un PDF buscable. Abre ese resultado en PDF a Word si también necesitas DOCX editable.
No. El flujo actual está diseñado para inglés impreso. Los manuscritos y otros idiomas no son entradas compatibles fiables.
Empieza por el resultado que necesitas y sigue un flujo claro con las herramientas adecuadas.