PDF से Word
OCR से स्कैन की हुई PDF को Word में कैसे बदलें
केवल चित्रों वाला स्कैन उपयोगी संपादन योग्य Word दस्तावेज़ बनने से पहले एक जाँची हुई टेक्स्ट परत प्राप्त करना चाहिए।
इस पृष्ठ पर
दृश्य उदाहरण देखें
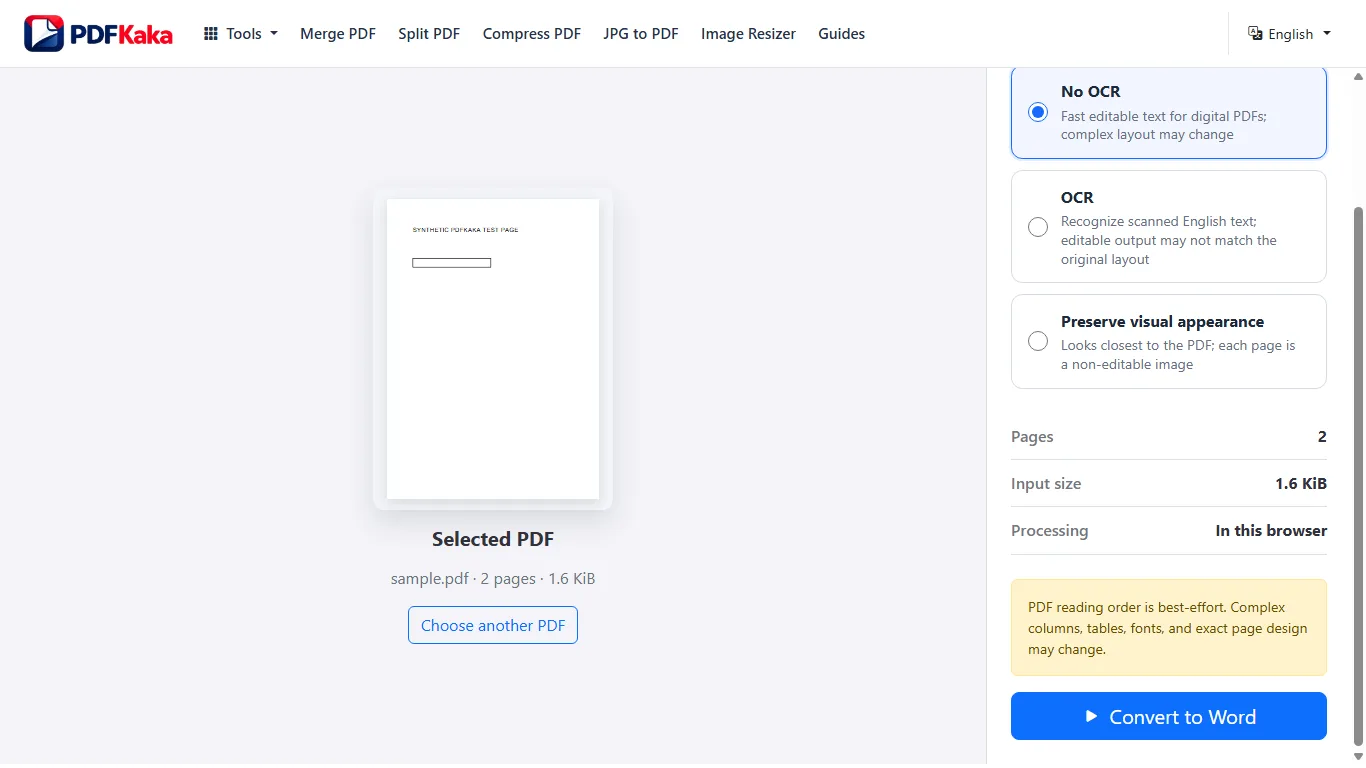
PDF to Word में OCR चुनें
स्कैन को PDF to Word में खोलें और स्कैन किए गए पृष्ठों के लिए अंग्रेज़ी OCR चुनें। OCR मोड अधिकतम 25 स्कैन किए गए पृष्ठों का समर्थन करता है और मुद्रित अंग्रेज़ी के लिए है। इसी रूपांतरण कार्यप्रवाह के दौरान पहचाना गया टेक्स्ट DOCX में रखा जाता है।
स्कैन की हुई PDF को DOCX में बदलें
OCR मोड चुनने के बाद रूपांतरण शुरू करें। कन्वर्टर पहचाने गए टेक्स्ट और उपलब्ध दस्तावेज़ संरचना से DOCX बनाता है। स्कैन और OCR से जो लेआउट जानकारी नहीं मिली, वह उसे वापस नहीं ला सकता।
Word दस्तावेज़ ठीक करें
स्तंभ, तालिकाएँ, अनुच्छेदों का क्रम, फ़ॉन्ट, पृष्ठ विराम और ग्राफ़िक्स के ऊपर रखा टेक्स्ट जाँचें। संपादन के दौरान स्कैन उपलब्ध रखें, ताकि पहचान और लेआउट के बदलावों की मूल से तुलना की जा सके।
पहचान की त्रुटियाँ और Word का लेआउट ठीक करने का काम अलग रखें
OCR तय करता है कि कौन से पहचाने गए अक्षर DOCX तक पहुँचते हैं; फिर PDF to Word उपलब्ध टेक्स्ट और पृष्ठ संरचना से संपादन योग्य दस्तावेज़ बनाता है। Word में नाम, तारीख और संख्याएँ ठीक करें, फिर स्तंभों, तालिकाओं, छवियों, फ़ॉन्ट और पृष्ठ विरामों को अलग लेआउट कार्य के रूप में जाँचें।
मिलते-जुलते अक्षरों वाला स्कैन किया हुआ बिल
AB10O जैसे खाता कोड की मूल छवि से तुलना करें और शून्य अंक तथा O अक्षर को अलग-अलग जाँचें। फिर रकम वाले स्तंभ और मुद्रा चिह्न देखें। दस्तावेज़ में किसी दूसरी जगह सही लगने वाला वाक्य पहचान कोडों या वित्तीय मानों की पुष्टि नहीं करता।
इसका पुन: उपयोग करने से पहले इस परिणाम की जाँच करें
- पुष्टि करें कि OCR का काम 25 स्कैन किए गए पृष्ठों की सीमा में है।
- DOCX में किसी पहचाने गए शब्द को संपादित करके पुष्टि करें कि वह वास्तविक टेक्स्ट है।
- स्कैन की जटिल तालिकाएँ दोबारा बनाएँ और हर जरूरी कुल रकम की मूल छवि से तुलना करें।
अक्सर पूछे जाने वाले सवाल
क्या PDF to Word खुद स्कैन के टेक्स्ट को पहचान सकता है?
हाँ। समर्थित केवल चित्रों वाले पृष्ठों के लिए PDF to Word में अंग्रेज़ी OCR मोड चुनें, फिर पहचाने गए DOCX टेक्स्ट की सावधानी से जाँच करें।
DOCX का लेआउट स्कैन से अलग क्यों दिखता है?
OCR टेक्स्ट पहचानता है, जबकि Word को बहते हुए दस्तावेज़ की संरचना चाहिए। स्तंभ, तालिकाएँ, फ़ॉन्ट और सटीक स्थान उपलब्ध जानकारी के आधार पर यथासंभव बनाए जाते हैं।
क्या हस्तलिखित टेक्स्ट को संपादन योग्य Word टेक्स्ट में बदला जा सकता है?
PDFKaka का वर्तमान OCR मुद्रित अंग्रेज़ी के लिए है; हस्तलिखित सामग्री का भरोसेमंद रूपांतरण समर्थित नहीं है।
क्या Word OCR चुनने से पहले OCR PDF चलाना जरूरी है?
नहीं। PDF to Word में अपना समर्थित अंग्रेज़ी OCR मोड है। अलग OCR PDF उपकरण तब उपयोगी है, जब जाँचने या आगे उपयोग करने के लिए खोजने योग्य PDF भी चाहिए।