PDF a texto
Cómo extraer texto seleccionable de un PDF
Crea un UTF-8 con caracteres ya almacenados en un PDF digital y conserva títulos opcionales de página para revisar.
En esta página
- Extrae el texto PDF
- Extraer texto no sustituye el OCR
- Un informe digital con una tabla
- Comprueba el resultado antes de reutilizarlo
- convertir un PDF escaneado a texto con OCR
- Paso 1: reconoce las páginas escaneadas
- Paso 2: extrae el texto reconocido
- Limpia el TXT sin perder el significado
- Un archivo de recibos escaneados
- Comprueba el resultado antes de reutilizarlo
- copiar texto PDF desde el móvil sin iniciar sesión
- Extrae el texto PDF
- Copiar una referencia de una carta PDF
- Comprueba el resultado antes de reutilizarlo
Ver un ejemplo visual
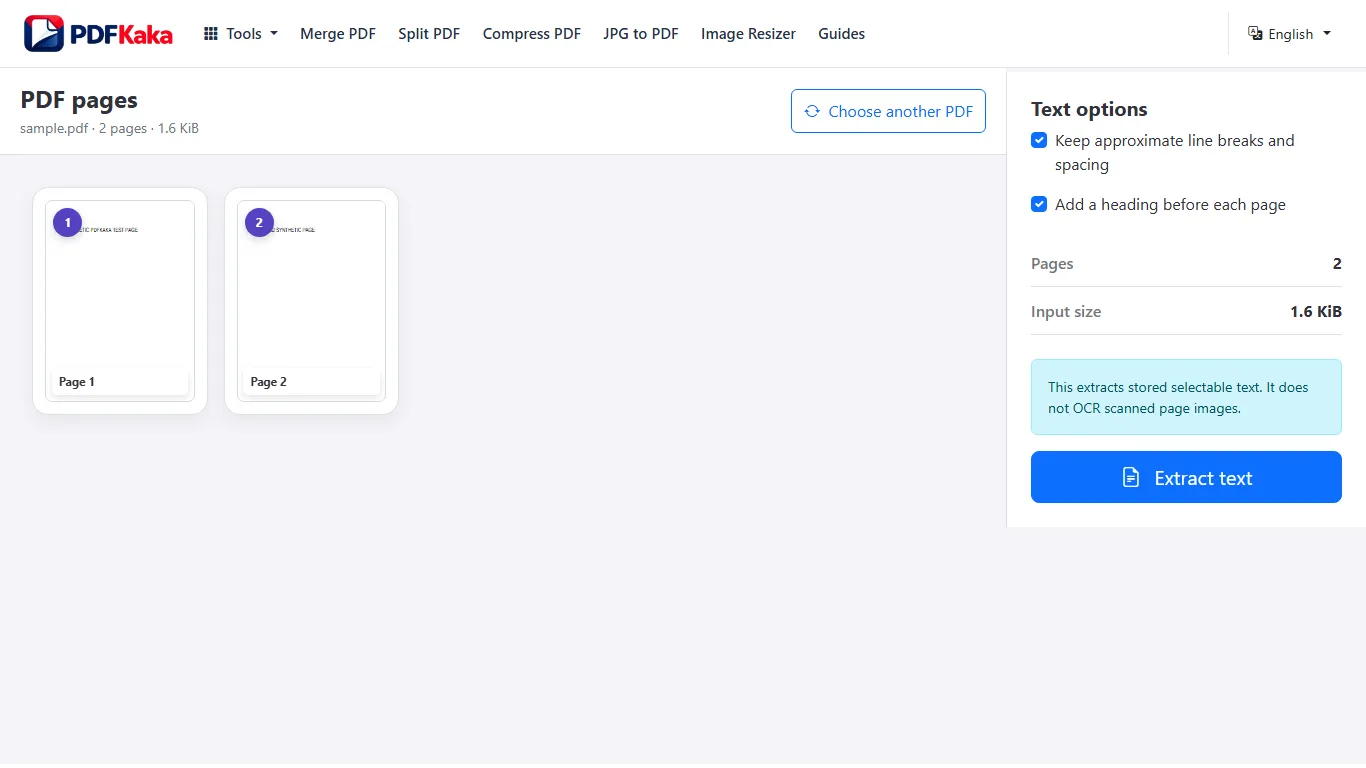
Extrae el texto PDF
- Abre PDF a Texto y elige un archivo con texto seleccionable útil.
- Elige si conservar líneas y espacios aproximados y añadir títulos de página.
- Extrae y revisa la vista previa, incluidas páginas con columnas o tablas.
- Pon nombre y descarga el UTF-8 TXT.
- Compara la copia con páginas iniciales, intermedias y finales; aplica OCR primero si las palabras necesarias solo están en imágenes.
Extraer texto no sustituye el OCR
Solo extrae texto seleccionable almacenado; sin OCR ni imágenes de página.
Un informe digital con una tabla
Busca una frase conocida y extrae el archivo. En el TXT revisa por separado un párrafo normal y una fila de tabla: pueden estar todos los números y faltar sus relaciones de columna. Usa el PDF como referencia de títulos, unidades y contexto.
Comprueba el resultado antes de reutilizarlo
- Verifica un pasaje de las páginas primera, intermedia y final.
- Revisa si se omite contenido en documentos con texto nativo y escaneos mezclados.
- Confirma el orden del texto descargado antes de pegarlo en otro lugar.
convertir un PDF escaneado a texto con OCR
Un escaneo contiene imágenes, mientras PDF a Texto lee objetos de texto ya almacenados. Por eso un escaneo necesita primero reconocimiento.
Crea y revisa un PDF buscable con OCR PDF, abre esa salida en PDF a Texto y descarga TXT. PDF a Texto lee texto almacenado; no reconoce por sí solo palabras en imágenes.
Paso 1: reconoce las páginas escaneadas
Abre OCR PDF con el escaneo. El reconocedor actual es para inglés impreso y admite hasta 25 páginas por trabajo. Descarga el resultado buscable, busca palabras y compara manualmente nombres, fechas y números con las imágenes originales.
Si está borroso, inclinado, oscuro o demasiado pequeño, mejora las imágenes antes de considerar utilizable el texto reconocido.
Paso 2: extrae el texto reconocido
Abre el OCR revisado en PDF a Texto. Elige espacios aproximados y títulos de página si ayudan, revisa la vista previa y descarga UTF-8 TXT.
PDF a Texto lee la capa reconocida del primer paso. No devuelve imágenes ni conserva el diseño visual original.
Limpia el TXT sin perder el significado
Líneas, columnas, tablas, encabezados y pies pueden producir un orden incómodo. Compara cada pasaje corregido con el escaneo antes de quitar saltos o repeticiones. Mantén el PDF buscable junto al TXT para conservar contexto.
Un archivo de recibos escaneados
Después del OCR, busca un recibo y compara el importe con su imagen. Extrae la copia revisada y confirma que número, importe y fecha sigan asociados al mismo recibo. El texto plano no conserva su diseño.
Comprueba el resultado antes de reutilizarlo
- Verifica que la copia OCR tenga texto buscable antes de abrir PDF a Texto.
- Conserva títulos de página en la primera revisión si ayudan a localizar el original.
- Compara el último recibo además de la primera página.
copiar texto PDF desde el móvil sin iniciar sesión
Extrae texto seleccionable a un TXT descargable desde el navegador móvil sin registrarte.
Elige un PDF buscable del teléfono, configura espacios y títulos, extrae y descarga TXT. Abre la copia en un editor para comprobar orden y caracteres; los escaneos necesitan OCR primero.
Extrae el texto PDF
- Abre PDF a Texto en el navegador móvil y selecciona el archivo.
- Revisa las páginas y elige espacios aproximados y títulos según necesites.
- Extrae y revisa pasajes de más de una página original.
- Pon nombre y descarga el TXT; búscalo en Descargas o Archivos.
- Ábrelo en un editor y compara un nombre, número y párrafo final con el PDF.
Copiar una referencia de una carta PDF
Usa el TXT para evitar transcribir una referencia larga, pero compara cada carácter. Si una aplicación muestra todo en una línea, revisa su ajuste de líneas antes de suponer que se perdieron los saltos.
Comprueba el resultado antes de reutilizarlo
- Confirma que elegiste la versión buscable, no una copia solo de imágenes.
- Comprueba los caracteres especiales en el editor del texto descargado.
- Mantén accesible el PDF al revisar una tabla o página de dos columnas.
Preguntas frecuentes
¿PDF a Texto aplica OCR a los escaneos?
No. Extrae texto que ya existe. Usa primero OCR PDF para escaneos solo de imágenes.
¿Cuál es el límite actual de PDF a Texto?
Un PDF de hasta 50 MiB y 500 páginas, con hasta 1,000,000 caracteres extraídos. El texto también debe respetar el límite de bytes mostrado.
¿Qué crea PDF a Texto?
Extrae texto seleccionable almacenado a UTF-8 TXT con espacios aproximados y títulos añadidos opcionales. No realiza OCR, no incluye imágenes ni elimina automáticamente encabezados repetidos.
¿Encontrar las palabras correctas demuestra que el orden está bien?
No. El PDF puede almacenar palabras en otro orden que el visual. Compara columnas, pies y tablas con el original.
¿Por qué se extrae poco o nada de un escaneo?
Puede contener solo imágenes. Ejecuta OCR PDF, revisa la capa reconocida y después extrae.
¿Puedo abrir directamente un escaneo en PDF a Texto?
Sí puede abrirse, pero no reconoce palabras de imagen. Necesitas OCR si no existe texto seleccionable.
¿El TXT conservará el diseño escaneado?
No. Almacena texto plano; columnas, tablas, espacios y diseño pueden necesitar limpieza manual.
¿Por qué un escaneo produce TXT con contenido pero incompleto?
Algunas páginas pueden tener texto y otras solo imágenes, o el OCR reconocer solo una parte. Compara todas las necesarias; una salida no vacía no demuestra que esté completa.
¿Necesito iniciar sesión para extraer?
El proceso actual no exige cuenta y procesa localmente. La ubicación de descarga y la aplicación que abre TXT dependen del teléfono.